Étude de cas complète
Le contexte : des données embarquées dont dépendent le social, le planning et la conformité
Groupe SF est un groupe de transport routier installé en Loire-Atlantique. Son activité repose sur un parc de tracteurs et de remorques, et sur les conducteurs qui les font rouler. Le groupe a beaucoup investi dans son informatique embarquée : chaque véhicule transmet sa position, ses temps de conduite et les fichiers de son tachygraphe.
Ces données ne servent pas qu’à suivre les tournées. Elles alimentent le suivi social des conducteurs, la planification et les obligations réglementaires : les fichiers du tachygraphe et de la carte du conducteur doivent être collectés dans des délais fixés par la loi. Une remontée qui s’interrompt a donc un coût, et il grandit avec le temps passé avant de s’en apercevoir.
Le service informatique voulait un portail unique, construit brique par brique. La première devait répondre à une question simple : quels véhicules ne remontent plus leurs données, et depuis quand ?
Le point de départ : une information dispersée entre quatre familles d’outils
Avant le projet, l’information existait, mais dispersée. Un agrégateur télématique donnait la géolocalisation et l’activité des véhicules. Un logiciel de données sociales tenait le référentiel des conducteurs. Chaque constructeur de camions exposait ses propres données. Le logiciel de planification connaissait les véhicules à l’atelier ou sortis du parc.
Vérifier qu’un camion communiquait correctement supposait d’ouvrir plusieurs portails et de comparer des dates à la main. Aucun outil ne disait qu’un véhicule visible chez son constructeur avait disparu de l’agrégateur, ou l’inverse.
Le premier échange date du 17 mai 2021. Deux semaines plus tard, nous remettions un cahier des charges : le socle du portail, les droits par groupe et par brique, la brique « Anomalies communications ». Le feu vert est arrivé le 3 juin, dix-sept jours après le premier échange. Le développement a démarré en juillet.
Cinq défis : rapprocher, rester connecté, trier les alertes
Aucun de ces systèmes n’a été conçu pour dialoguer avec les autres. Le risque du projet ne se trouvait pas dans l’écran, mais dans la donnée qui l’alimente.
Six sources, aucun identifiant commun
- Le risque
- Les constructeurs désignent un camion par son numéro de châssis. Le logiciel de planification utilise l’immatriculation. Un conducteur se reconnaît à sa carte. Sans table de correspondance, impossible de dire que deux lignes parlent du même véhicule.
- Notre réponse
- Nous avons construit un référentiel unique des camions, des remorques et des conducteurs. Chaque source est d’abord copiée dans ses propres tables. Immatriculations et numéros de carte sont ensuite normalisés, puis rapprochés de ce référentiel.
- Résultat
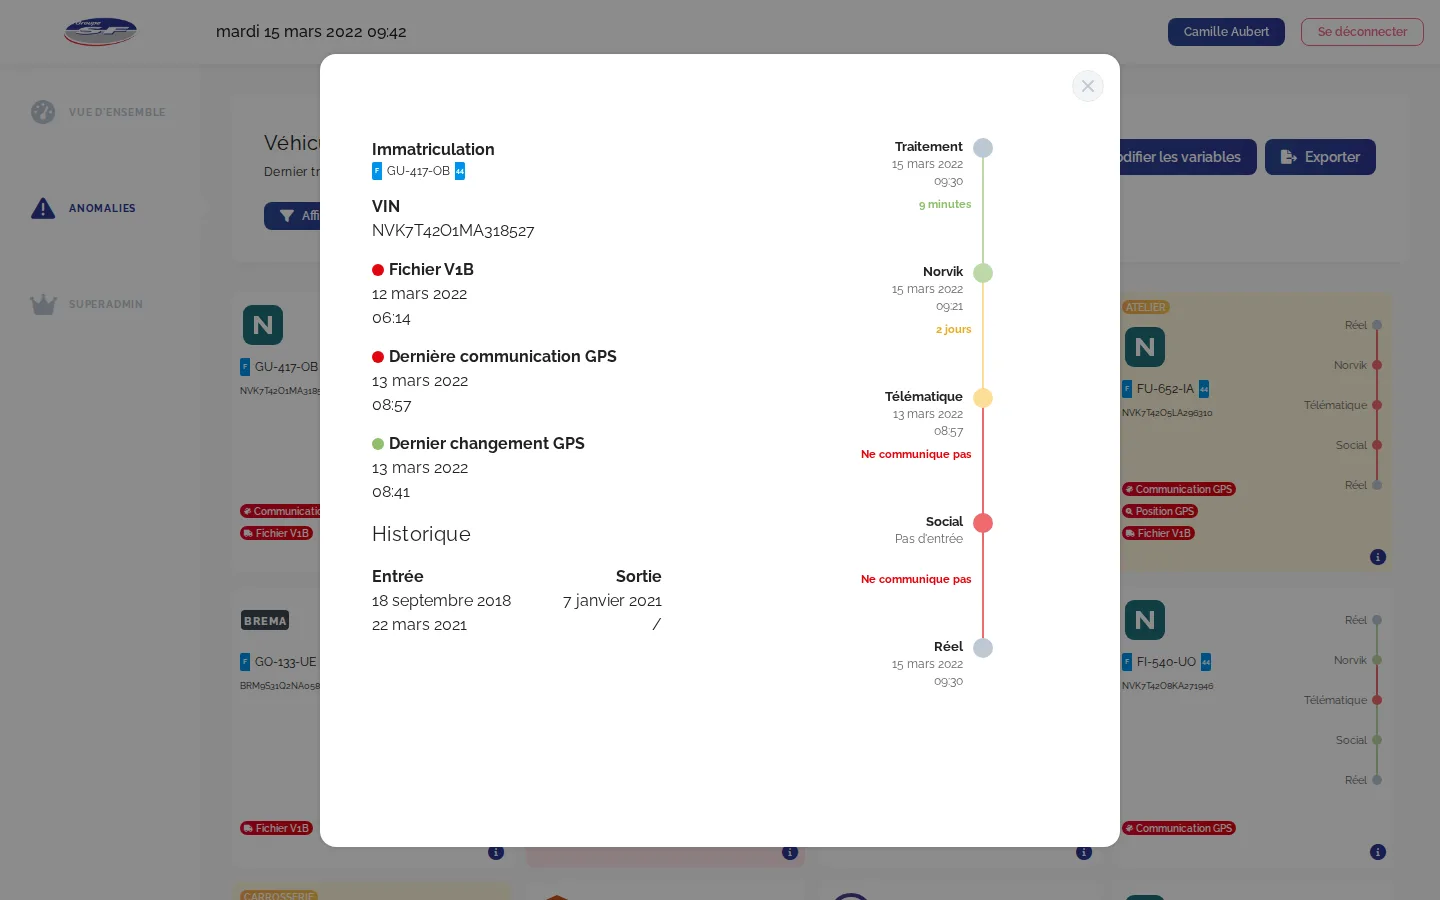
- Chaque véhicule dispose d’une fiche qui présente côte à côte ce que chaque système sait de lui, avec la date de sa dernière communication.
Des API qui ne se ressemblent pas
- Le risque
- Chaque fournisseur a son format, son rythme et ses limites. L’un recommande ses propres API plutôt que le standard du secteur. Un autre ne fournit pas de liste de référence. Le logiciel de planification n’offre aucune API : ses données dorment dans une base locale.
- Notre réponse
- Chaque source a son connecteur et sa commande de synchronisation, rejouable seule. Pour le planning, le client dépose des exports CSV sur un espace de fichiers auquel nous n’accédons qu’en lecture. Les réponses de l’agrégateur sont mises en cache une heure, pour ne pas le solliciter inutilement.
- Résultat
- Six sources sont interrogées sans intervention. Une septième, dont l’accès n’était pas encore ouvert, est couverte par les notifications par e-mail.
Une session qui expire toutes les deux heures
- Le risque
- Le portail de données sociales n’autorisait qu’une connexion par formulaire. Le jeton obtenu devait être renouvelé toutes les deux heures. Une synchronisation de nuit se retrouvait donc sans accès.
- Notre réponse
- Après analyse du protocole d’authentification, nous avons automatisé le renouvellement : une tâche planifiée rejoue la connexion chaque heure et conserve un jeton valide pour les traitements suivants.
- Résultat
- La synchronisation des conducteurs et des véhicules tourne sans saisie manuelle sur l’environnement de préproduction.
Distinguer la panne du camion à l’arrêt
- Le risque
- Un camion à l’atelier ne communique pas, et c’est normal. Si l’outil le signale chaque matin, plus personne ne lit les alertes.
- Notre réponse
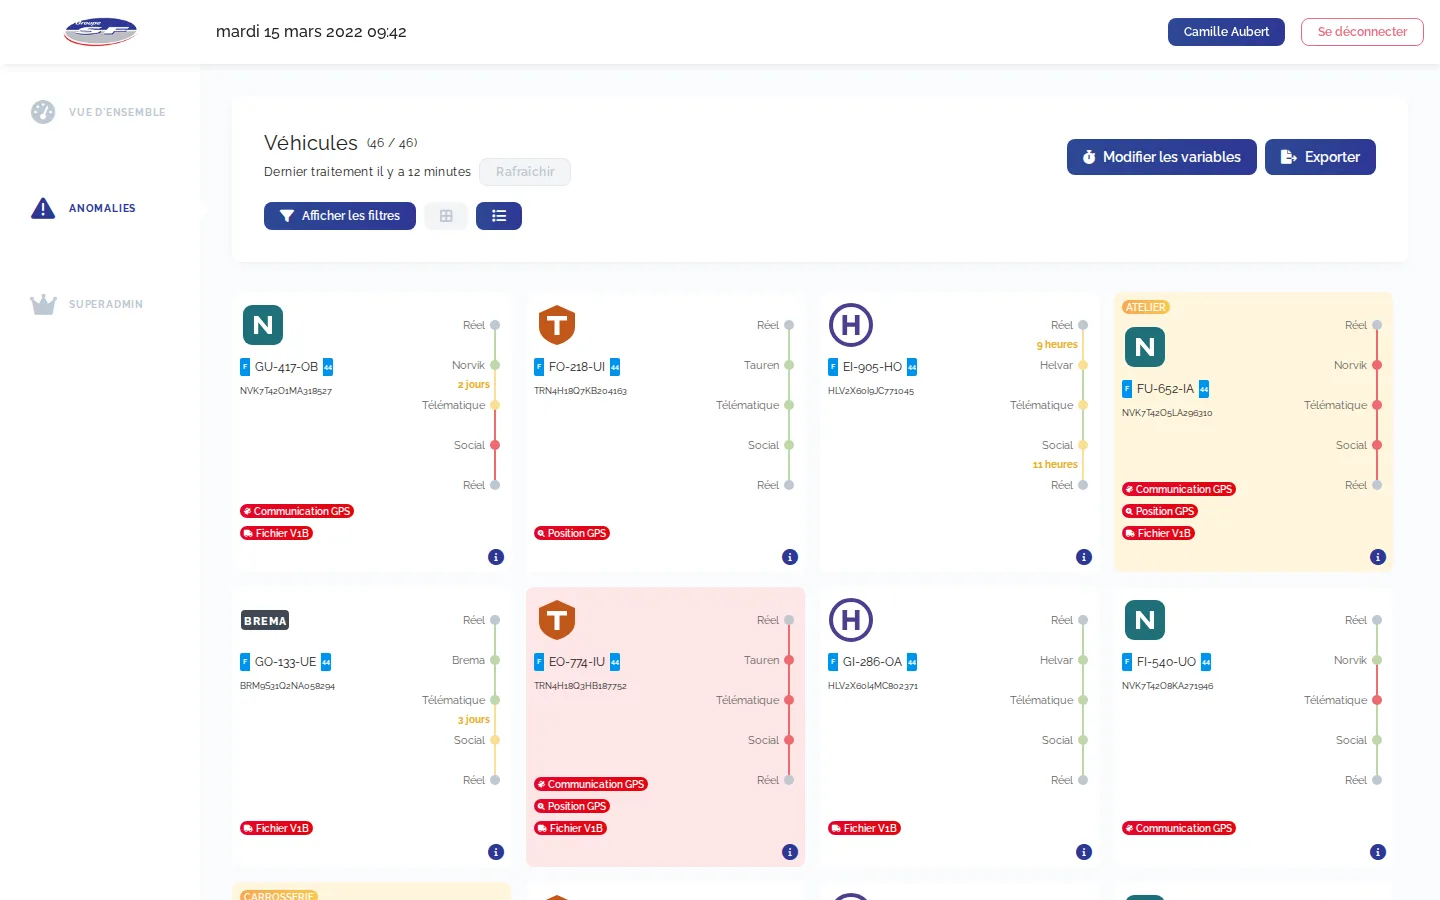
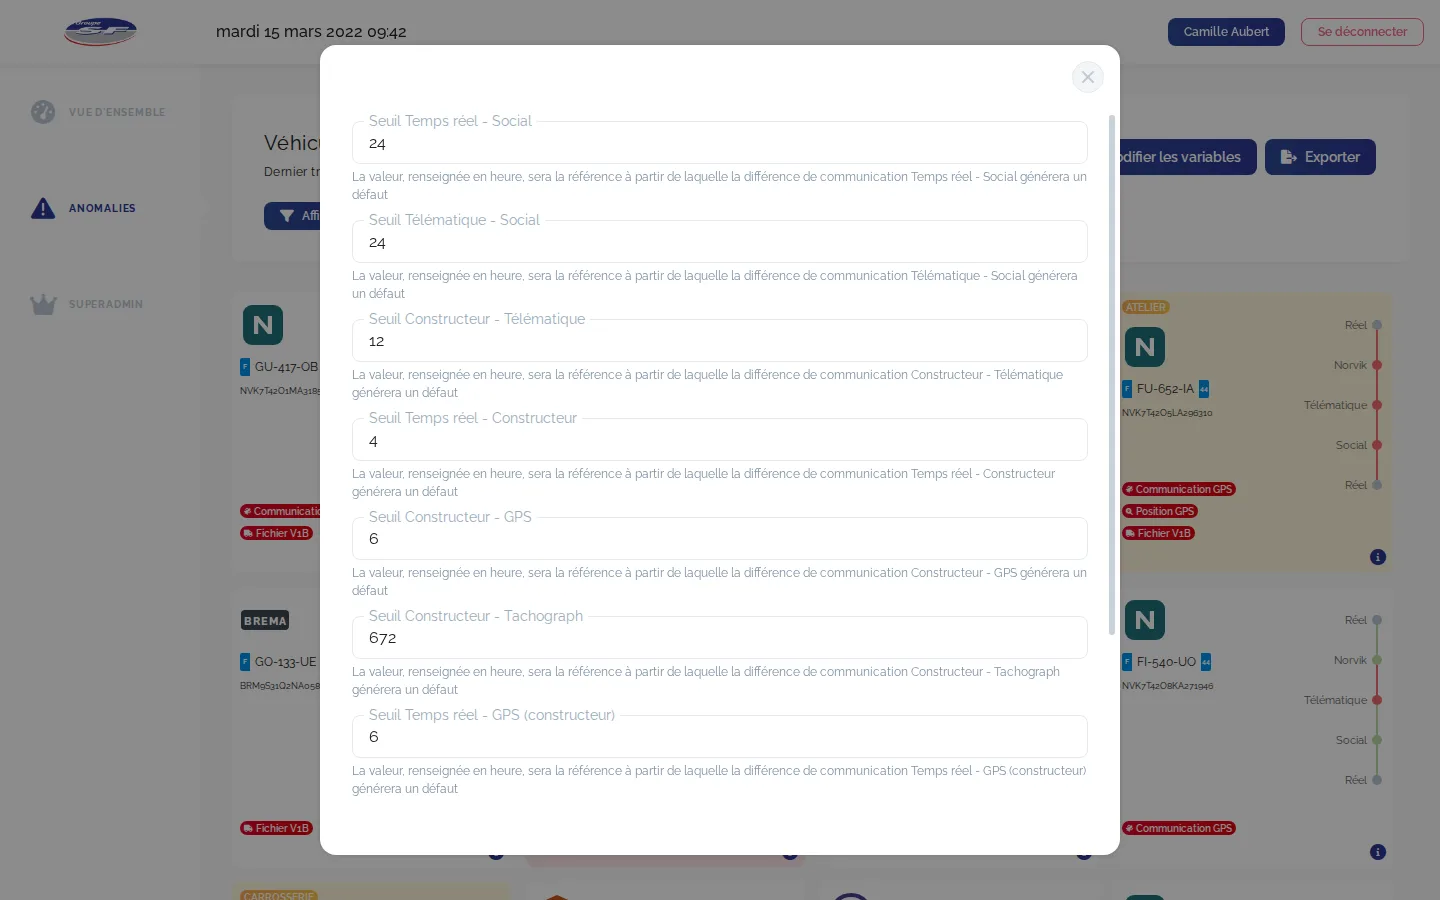
- Les indisponibilités issues du planning neutralisent ces cas, motif à l’appui. L’écran les distingue par un code couleur : jaune pour un véhicule indisponible, rouge pour un véhicule sorti du parc. Chaque seuil de retard, exprimé en heures, se règle depuis l’interface. Le cahier des charges exclut tout e-mail la nuit.
- Résultat
- La liste des anomalies se concentre sur les véhicules censés rouler, avec pour chacun la nature de l’écart et son ancienneté.
Suivre les entrées et les sorties de parc
- Le risque
- Un parc vit : des véhicules arrivent, d’autres le quittent. À chaque mouvement, il fallait prévenir le constructeur et mettre à jour l’agrégateur. Un oubli, et un camion sorti reste suivi, ou un camion neuf ne remonte rien.
- Notre réponse
- Le portail déduit ces mouvements du référentiel et en conserve l’historique. À chaque entrée ou sortie, un e-mail part vers le contact du constructeur concerné, et le véhicule est activé ou désactivé dans l’agrégateur.
- Résultat
- Demandée par le service informatique, cette automatisation a été livrée en mars 2022. Un véhicule sorti reste consultable, signalé en rouge, avec ses dates d’entrée et de sortie.
La solution : un socle de droits et une première brique de contrôle
Le socle gère les comptes, les groupes et les droits par brique : lecture, écriture, notifications. Trois profils existent. L’analyste consulte et exporte. Le profil d’écriture relance un traitement. Le super-administrateur gère les comptes et les seuils. Les briques suivantes s’y branchent sans refaire l’authentification.
La brique « Anomalies communications » compare trois dates pour chaque véhicule : la dernière communication, la dernière position GPS et le dernier fichier de tachygraphe. Elle confronte ensuite les sources entre elles et signale sept types d’écarts.
- Un véhicule connu du terrain mais absent chez son constructeur, ou présent chez le constructeur mais absent de l’agrégateur.
- Un conducteur ou un véhicule que l’agrégateur et le logiciel de données sociales ne décrivent pas de la même façon.
- Une position GPS figée : deux relevés successifs strictement identiques.
- Un fichier de tachygraphe ou de carte conducteur qui dépasse le délai fixé.
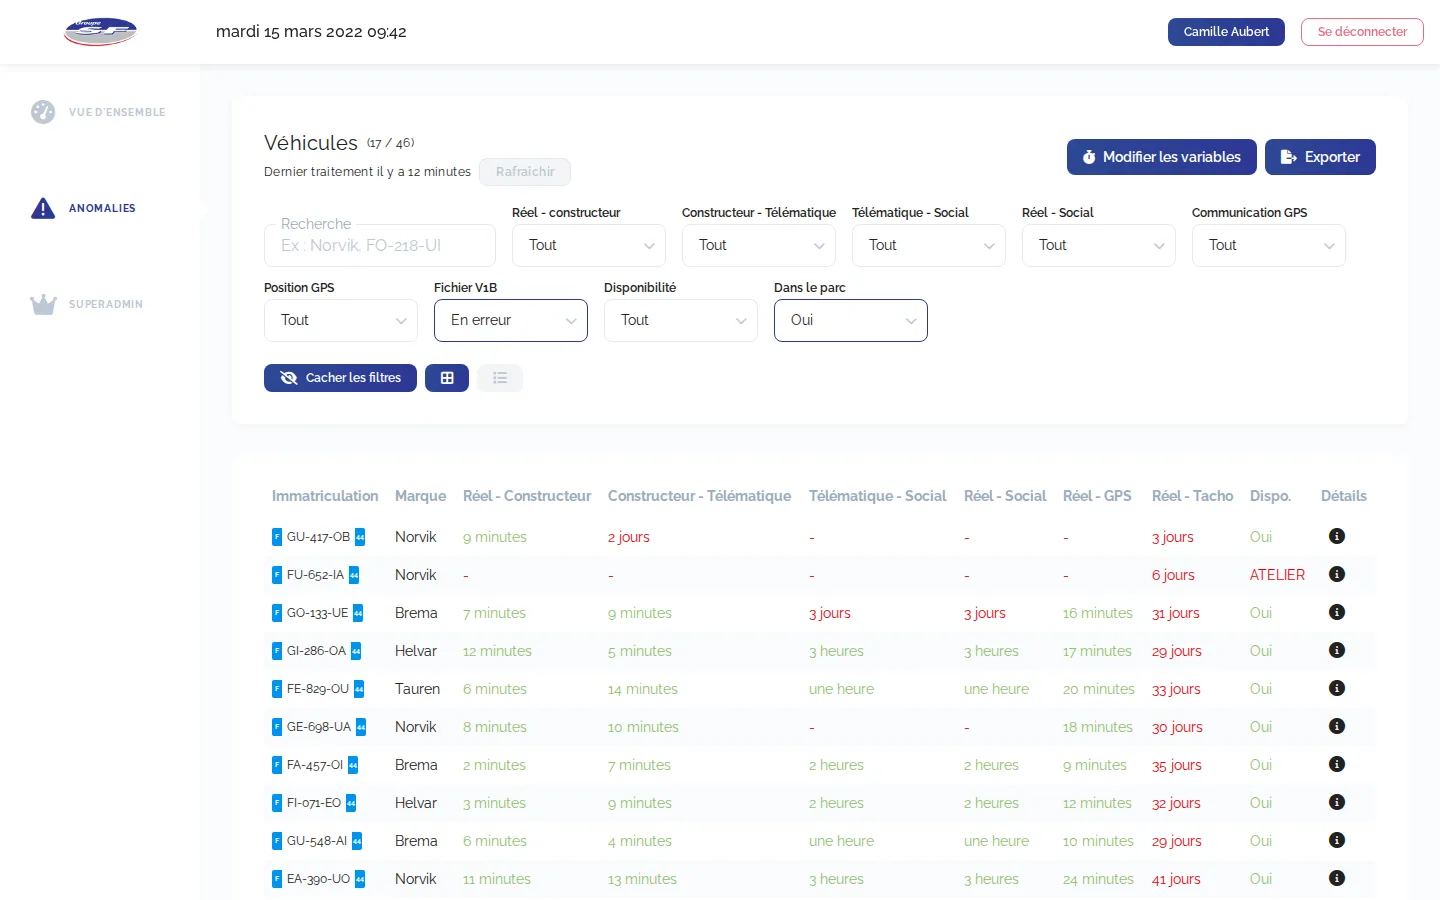
L’écran s’affiche en cartes ou en tableau, avec un compteur, neuf filtres et une recherche par marque, immatriculation ou numéro de châssis. Un bouton exporte la liste filtrée dans un classeur Excel. Une frise par véhicule montre où la chaîne se rompt. Le même contrôle s’applique aux cartes des conducteurs ; les remorques, elles, figurent déjà dans le référentiel.
Les choix techniques : copier avant de comparer, régler sans redéployer
Le portail sépare une API Laravel et une interface Next.js. Ce découpage répond à la demande initiale : plusieurs briques, et à terme une application mobile, devaient consommer les mêmes données.
Copier avant de comparer
Deux options se présentaient. Interroger chaque fournisseur à l’ouverture de l’écran était simple, mais lent et dépendant de la disponibilité de chaque service. Nous avons préféré copier les données à intervalle régulier, puis calculer les anomalies sur cette copie. L’écran répond vite, et un fournisseur indisponible ne bloque pas les autres.
Un traitement qui se rejoue sans dégât
Chaque traitement est enregistré avec son état. Un nouveau lancement annule celui qui serait resté en cours, et l’écran affiche l’heure du dernier traitement terminé. L’utilisateur sait de quand datent les données qu’il lit.
Une fréquence réglable
Le planificateur vérifie chaque minute si le délai choisi par le super-administrateur est écoulé, puis lance les synchronisations dans l’ordre. La fréquence se règle donc depuis l’écran des paramètres, sans intervention sur le serveur.
Des droits vérifiés par l’API
L’interface ne décide de rien. Chaque route de l’API contrôle le jeton de session, puis le droit demandé : lecture, écriture ou super-administration. La documentation de l’API est générée à partir du code. Les tests automatisés de l’authentification s’exécutent à chaque demande de fusion. C’est le socle que nous posons sur nos projets de logiciel métier.
La méthode : livrer source par source, au rythme des accès
Notre rôle a couvert la rédaction du cahier des charges, la conception, le développement de l’API et de l’interface, puis l’hébergement de la préproduction. Le service informatique du client a obtenu les accès auprès de chaque éditeur. C’est le chemin critique d’un tel projet : certains accès ont demandé des mois, d’autres un document de conformité au RGPD.
Nous avons donc avancé source par source, en livrant sur la préproduction dès qu’un accès s’ouvrait. Les échanges avec le responsable des systèmes d’information ont servi de recette continue : un camion absent d’une API, un filtre à corriger, une règle à nuancer.
Une documentation technique décrit chaque commande de synchronisation, ses options et le format des fichiers attendus. Le 12 mai 2022, une journée d’entretiens avec les responsables de service a recueilli leurs besoins pour les briques suivantes.
Les résultats : deux versions livrées en préproduction
La première brique a été livrée sur la préproduction que nous hébergeons, et ouverte aux tests du client le 3 février 2022. Elle a évolué au fil de ses retours jusqu’au printemps 2022.
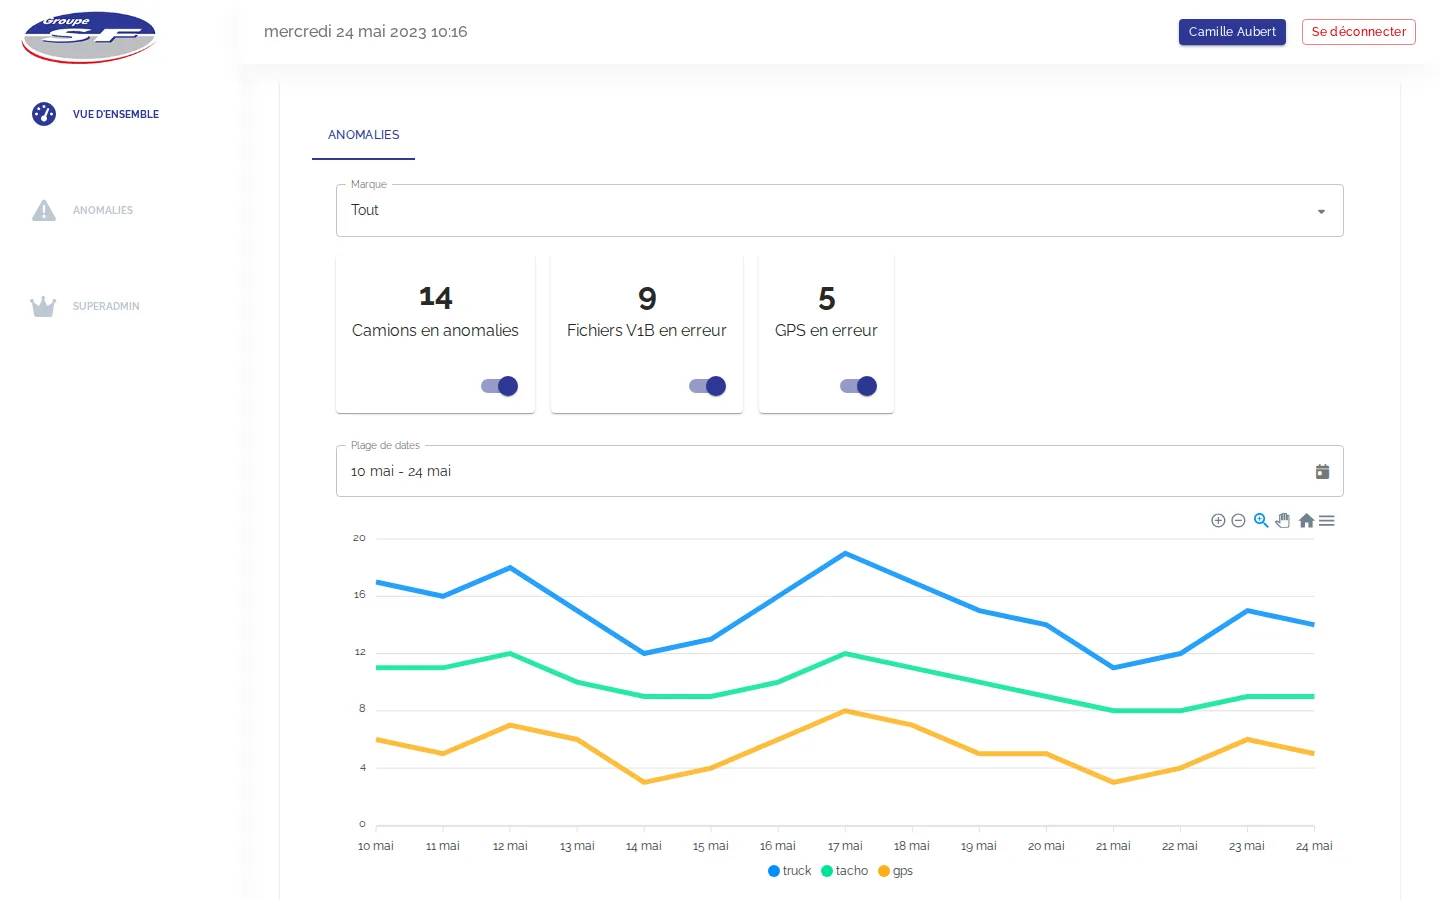
En mai et juin 2023, une seconde version a repris l’API et l’interface sur des versions plus récentes des mêmes outils. Elle ajoute une vue d’ensemble : compteurs, filtre par marque et courbes sur la période choisie.
Le portail a été livré et éprouvé en préproduction, branché sur les API des fournisseurs. Il n’a pas été mis en production : nous ne publions donc aucun chiffre d’usage. Ce qui est acquis est d’un autre ordre.
- Six sources rapprochées sans ressaisie dans un référentiel unique.
- Sept types d’écarts détectés, expliqués à l’écran et exportables.
- Un socle de comptes et de droits, prêt à accueillir d’autres briques.
Pour un acteur du transport, ce travail a aussi une valeur documentaire. Les règles de rapprochement, les seuils et les cas particuliers de chaque fournisseur sont désormais écrits : dans le cahier des charges, dans la documentation technique et dans le code.
Ce que nous en retenons
- Les accès sont le vrai planning. Si votre projet dépend d’API tierces, son calendrier est celui des éditeurs. Faites ouvrir les accès avant le premier sprint, et livrez source par source plutôt que d’attendre que tout soit prêt.
- Un référentiel avant les écrans. Tant que deux systèmes ne désignent pas un véhicule de la même façon, aucun tableau de bord n’est fiable. Le rapprochement se décide avec le métier, pas dans le code seul.
- Une alerte utile est une alerte rare. Neutraliser les cas normaux, comme l’atelier ou la sortie de parc, et laisser le métier régler les seuils compte autant que détecter les anomalies.
Réponse sous 24 h ouvrées